問題不是「能不能叫 AI 寫程式」,而是任務如何被系統承接
AI coding 的第一步通常很簡單:使用者在聊天視窗丟出一句需求,請 agent 建立一個頁面、修一個 bug,或檢查某個專案。但只靠聊天視窗本身,並不能保證 agent 知道自己應該在哪個專案工作、要延續哪一次對話、目前是否已有任務正在執行,也不能保證最後產物真的能在瀏覽器中打開。
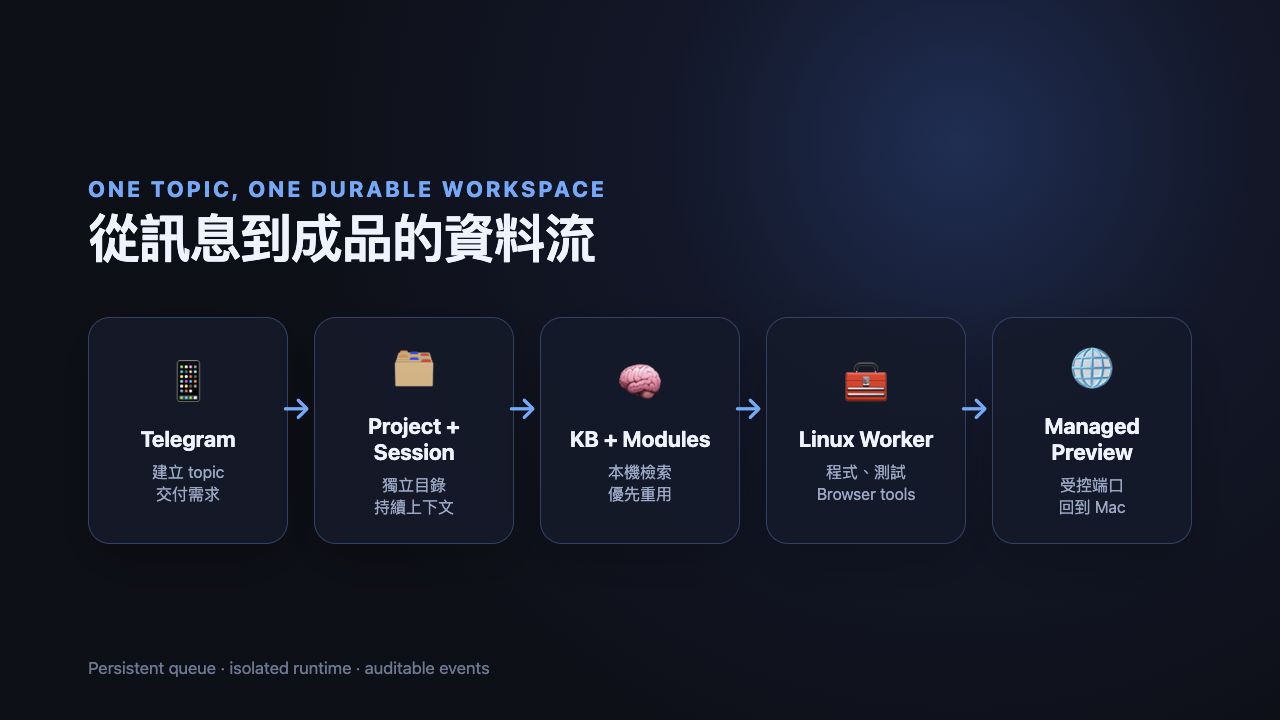
因此 TG+OpenCode 的核心設計,是把「一則訊息」轉成一個有身份、有排程、有邊界、有證據的工程任務。Telegram Forum 負責使用者入口與專案分流;OpenCode Session 負責 agent 對話、工具呼叫與程式修改;Docker worker 負責隔離執行;Host capability broker 只在必要時提供受控的主機能力;最後再透過測試、preview 與 Chrome DevTools 驗收,把結果交回使用者。
這篇文章的重點不是宣稱 AI Agent 能夠自行完成所有工程問題,而是說明工程師設計的 Harness 如何把架構設計、安全邊界、可觀測性與 Benchmark 治理產品化,讓模型輸出能被排程、驗收、追溯與持續改善。
用 Telegram Forum 建立多專案入口
Telegram 在這裡不是單純的通知管道,而是專案操作介面。使用者可以在指定入口建立新 project,系統會把 project name 轉成安全的 slug,檢查目錄衝突,建立對應的 Telegram Forum topic、本地專案目錄與 OpenCode 設定。完成後,這個 topic 就成為該專案的固定入口。
這個設計讓「專案身份」不再依賴使用者每次描述,也不依賴模型自己記憶。每個 project topic 會綁定到固定的 project path 與 OpenCode Session;隔天使用者回到同一個 topic 追問,系統仍知道應該在同一份檔案樹與同一段任務脈絡中繼續。General topic 則刻意採一次性 session,適合不需要累積上下文的短任務,避免簡單查詢被舊專案背景污染。
OpenCode Session 與持久 queue:讓長任務不靠運氣
一個 coding 任務可能持續數分鐘到數十分鐘。若同一個 topic 的第二則需求直接併發執行,兩個 agent 可能同時改同一個檔案、搶同一個 port,或在不同假設下跑測試。TG+OpenCode 因此在 project 層建立持久 queue:同一個 topic 的需求依序執行,新訊息在 busy 時先保存起來,而不是只存在 process memory。
系統會把 topic、project path、OpenCode Session、active prompt 與 pending queue 寫入持久狀態。Bridge 重啟後,可以載入既有 binding;尚未完成的 active prompt 會回到 queue 前端,避免任務靜默遺失。使用者也可以取消尚未執行的 queue item,或用明確指令中止已經開始的 subprocess。
這裡的重點是把任務狀態做成產品能力。正常結束但沒有可交付文字時,系統不會把空白當成功,而是先在同一個 session 補跑;若連續無法交付,才進入 compact 或明確要求使用者重新送出需求。這讓錯誤有邊界,也讓使用者知道任務到底是完成、取消、重試中,還是需要人工介入。
隔離的 Docker worker:讓 agent 能做事,但不要拿到整台主機
OpenCode server、模型選擇的工具與專案程式都在隔離的 Linux Docker worker 中執行。Worker 可以讀寫指定 project workspace,因為這是 agent 完成交付所需的能力;但它不直接取得 host home、SSH private key、Telegram secrets、OpenCode 認證資料、Docker socket 或主機 process namespace。
專案目錄以相同絕對路徑掛載,讓 container 裡寫出的檔案可以直接在 Mac 上檢查與部署;但這不代表共享整個作業系統。macOS 的虛擬環境、host socket、native binary 與 localhost 都不會被誤當成 worker 內部可用資源。這個分界讓 agent 有足夠能力開發,又不會因為一次錯誤工具呼叫接觸到整台開發機的控制面。
Host capability broker:把必要的主機能力做成窄介面
有些任務確實需要 worker 以外的能力,例如查看允許的遠端機器、執行受限 SSH 命令,或把 container 內啟動的 web service 發布到 Mac 本機瀏覽器。這些能力不直接把 SSH config、私鑰或 host shell 掛進 worker,而是透過 Host capability broker 提供。
Broker 的原則是最小權限:worker 只能呼叫具名能力,看見 allowlist 內的遠端 alias,並受到 timeout、輸出大小與 hard deny 規則限制。對 web app 來說,agent 必須讓服務在 container 內監聽正確介面,再透過系統自定義好的 preview 工具發布到 Mac 的 loopback URL。這避免了常見錯誤:agent 在 container 內 curl localhost 成功,但使用者在 Mac 瀏覽器根本打不開。
Knowledge preflight 與模組重用:讓 agent 先讀已有脈絡
每個 project turn 執行前,系統會先做 knowledge preflight。這不是把整個知識庫塞進 prompt,而是用本地檢索找出真正相關的片段,通過門檻才注入;沒有足夠相關性時就回報 no-match。這樣可以避免模型在不該套用舊知識時硬套,也保留每輪使用了哪些知識的 audit trail。
除了知識檢索,系統也把可重用程式能力整理成 module catalog。Agent 在開發前可以搜尋既有模組,檢查相容性與驗證命令,而不是每次重造輪子。知識庫處理的是「如何推理、哪些 failure mode 要注意」;module catalog 處理的是「有哪些程式能力可以直接重用」。兩者分層後,agent 比較不容易把一次性的操作紀錄誤當成永久規則。
Browser QA:交付要回到真實畫面
對 web 任務而言,只看原始碼或測試輸出不夠。TG+OpenCode 把 preview 與 Chrome DevTools 放進驗收流程,讓 agent 可以檢查 DOM、console、network、computed style、資源載入與實際互動狀態。這一層在後續的踩地雷與西洋棋案例中特別重要:許多問題不是程式碼看起來錯,而是瀏覽器中的畫面、資源或狀態不同步。
因此,browser QA 在這套系統裡不是額外的人工步驟,而是 agent workflow 的一部分。當系統宣稱完成 web app,至少要能說明服務如何啟動、preview 如何發布、瀏覽器看到了什麼、console 或 network 是否有錯,以及使用者回饋後如何重新驗證。
Observability:用 JSONL event log 留下可回看的證據
每輪執行都會產生 JSONL event log,記錄 OpenCode 事件、工具呼叫、stderr 與最終回覆;knowledge preflight 也會保留 query、命中 chunk、score 與來源。這些紀錄讓團隊能回頭分辨:某個結論是模型自己聲稱完成,還是有測試、瀏覽器、API 或 log 證明完成。
這點對 agent 系統很關鍵。若只看最後一段回覆,很容易把「模型認為做好了」誤當成「產品真的可用」。事件紀錄、進度訊息、runtime identity 與驗收結果放在一起,才能建立可追蹤的工程證據鏈。
Benchmark 與改進:評測的是 harness,不只是模型
模型可以變強,但一套 agent 系統的表現不只取決於模型。Telegram routing、queue、knowledge preflight、preview、browser QA、遠端能力、錯誤復原與工具設計都會影響最終交付。因此 TG+OpenCode 把 benchmark 和 harness improvement 也納入系統:用固定題目、heldout/regression/challenge 等資料集與 admission gate,判斷候選 harness 改動是否真的改善。
這樣做的目的,是避免「換了模型看起來比較會講」或「改了一段 harness 好像更順」這種主觀判斷。真正能進入下一版的改動,應該能在一致的任務與驗收規則下通過,並且保留 lineage、good set 與回滾路徑。
目前這套系統代表什麼
TG+OpenCode 的價值不在於單一功能,而在於把 AI coding 需要的幾個工程條件放在同一條流程上:使用者可以從手機建立與追蹤任務;任務有 project/topic/session identity;長任務有持久 queue;agent 在隔離 worker 中執行;必要主機能力透過 broker 受控提供;知識與模組可以被檢索與稽核;web app 能透過 preview 與 Chrome DevTools 驗收;最後,整個過程留下 event log 與 benchmark 證據。
也就是說,這不是把聊天訊息轉給 OpenCode 而已,而是一套把「需求 → 執行 → 驗收 → 回饋 → 改進」接起來的 AI 軟體工程基礎設施。後面的踩地雷與西洋棋實戰案例,則是用具體產品開發過程展示這套系統如何在真實任務中暴露問題、接收人工回饋,並推動 agent 重新修正。