為什麼需要 LLM 進一步理解事件
前一階段建立的 RAG retrieval pipeline,讓新的金融資訊進入系統時,可以先從歷史資料中找出與它相關的過往內容。但取得歷史背景之後,還需要進一步判斷:現在收到的這則資訊,相較於過去已經知道的內容,究竟帶來了什麼新的變化?
即時資訊流中並不是每一則新發布的消息都代表新的事件。同一件事情可能被不同來源反覆報導,也可能在事件發展過程中持續出現後續消息;有些更新只是重複已知資訊,有些則真正加入了可能改變市場判斷的新內容。
單純依靠關鍵字或文字相似度,很難處理這類差異。兩則文字寫法不同的新聞可能描述同一件事情,而兩則看似相近的新聞,也可能因為其中一個關鍵進展而具有完全不同的意義。
因此,我們在 historical retrieval 之後加入大型語言模型,利用 LLM 的文意理解能力,同時閱讀當前資訊與相關歷史資訊,判斷目前這則消息在既有事件脈絡中的位置。
我們並沒有直接要求模型回答「這則新聞重要嗎?」這樣的問題過於主觀,也很難直接成為後續程式的判斷依據。相反地,我們把實際關心的幾個資訊維度拆成固定欄位,讓模型先理解事件,再描述這則資訊的類型、新穎程度與可能影響。最終希望解決的是:從持續進入系統的大量新訊息中,進一步找出真正帶來新資訊,而且可能具有較大市場影響的內容。
提供給模型的 Context
要判斷一則新聞是不是「新的資訊」,只看當前新聞本身是不夠的。因此,每次進行分析時,我們除了提供 Current News,也會加入前一階段 retrieval pipeline 找出的 Related Historical News,讓模型知道過去曾經出現過哪些與目前事件相關的內容。
其中最重要的是 Current News 與 Related Historical News 之間的關係。Related Historical News 來自上一篇建立的 retrieval pipeline。系統會先利用 embedding 與 BM25 從歷史資料中找出與當前內容較相關的新聞,再將排名較高的結果提供給模型。
這些資料並不代表「一定是同一事件」,而是提供一個有限範圍的歷史背景。LLM 再利用文意理解能力,比較當前資訊與這些歷史內容,判斷目前描述的是既有事件的重複資訊、事件後續,還是歷史資料中尚未出現的重要進展。
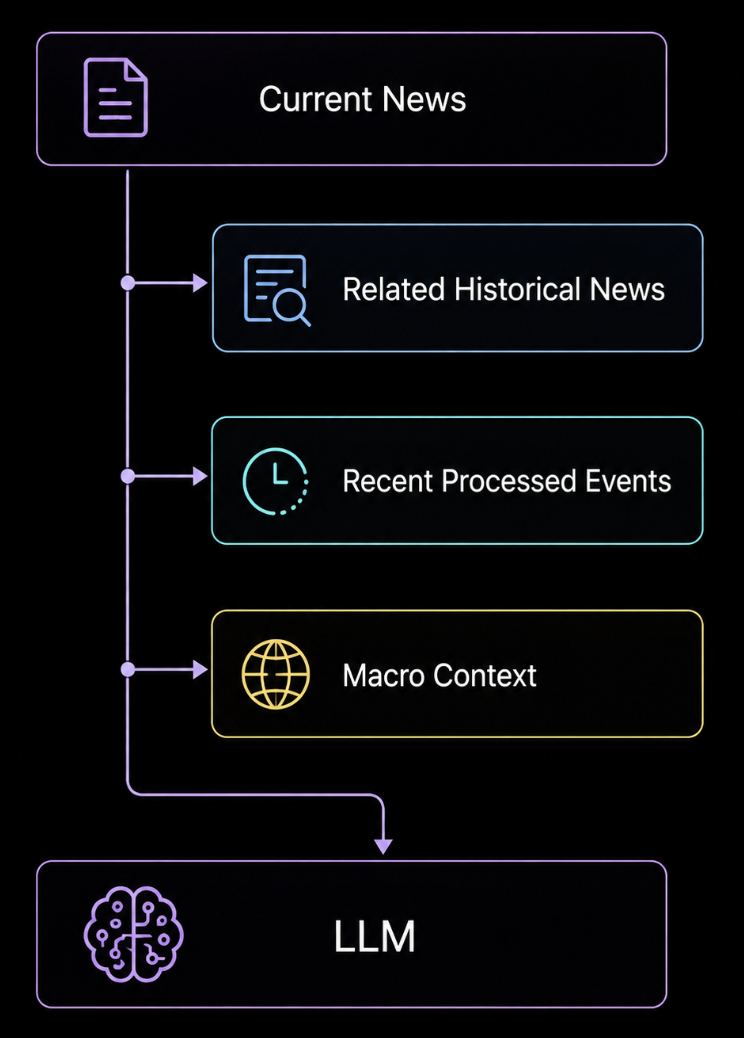
Retrieval 負責把可能相關的歷史資訊找出來,而 LLM 則負責理解這些資訊與當前新聞之間的事件關係。
將理解結果轉換成結構化欄位
我們沒有讓模型直接輸出一個主觀的「重要/不重要」結果,而是將判斷拆成幾個不同維度。其中主要使用 category、novelty 與 impact 三組資訊。
category 描述目前資訊在事件脈絡中的性質,例如它是一個新的具體事件、既有事件的小幅後續、對過去資訊的回顧,還是單純的評論或雜訊。novelty 則描述當前資訊相較於歷史資料的新穎程度。模型會參考前面提供的 historical context,區分第一次出現的重要事件、具有額外意義的後續資訊,以及沒有帶來明顯新內容的重複資訊。impact 關注的則不是資訊是否新,而是這項事件是否可能對相關金融標的產生足夠明顯的市場影響。
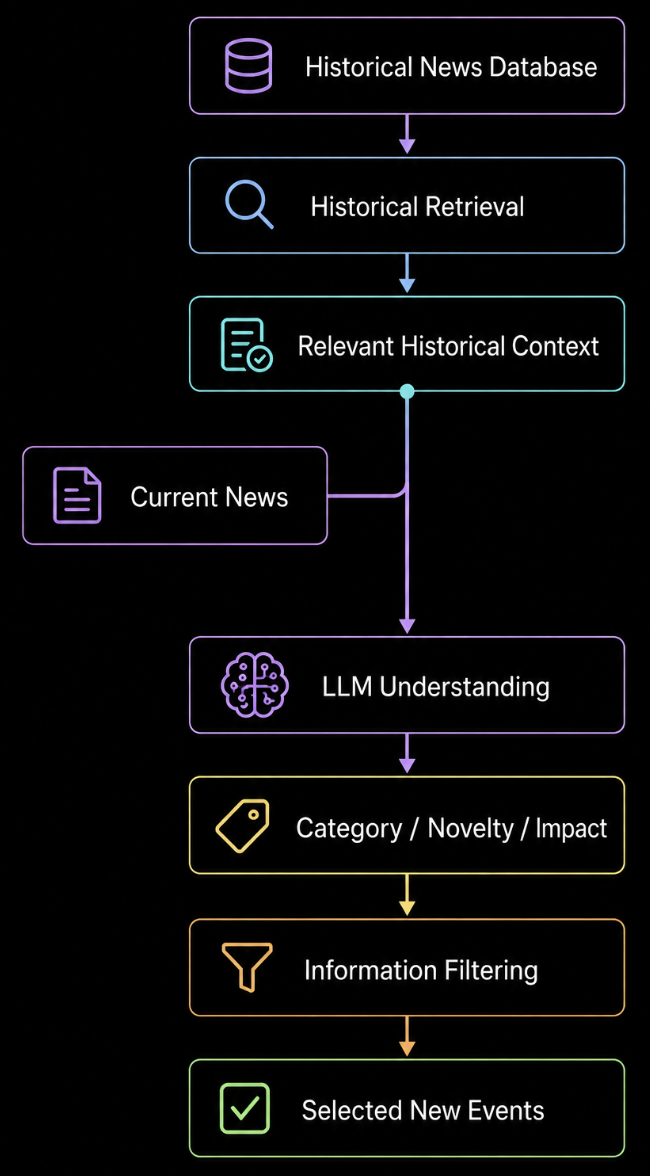
這樣做的目的,是把原本需要閱讀新聞與歷史背景才能形成的判斷,轉換成後續程式可以直接使用的資料。例如,系統可以進一步挑出同時具有較高 novelty、屬於實際事件而非回顧或評論,且具有較大 impact 的資訊。
換句話說,LLM 負責理解文意以及事件在歷史脈絡中的位置,而固定欄位則讓這份理解可以被後續系統利用。
從歷史資訊找到真正的新事件
前一階段的 RAG retrieval 解決了如何從大量歷史新聞中找到與當前資訊相關的內容。取得這些 historical context 後,下一步就是利用 LLM 理解當前新聞與歷史資訊之間的關係。
對我們而言,LLM 在這裡最重要的用途是利用模型對自然語言與上下文的理解能力,判斷目前這則資訊相對於過去已知資訊,究竟帶來了什麼新的變化。
例如,同一項監管政策可能在短時間內被不同媒體或社群帳號反覆報導。每一則都是系統新收到的資料,但不代表每一則都是新的事件。如果歷史資訊中已經出現相同事件,而目前新聞只是再次轉述,就不應該被當成新的市場資訊重新處理。
模型會將理解結果整理成幾個結構化欄位。其中 category 用來描述目前資訊屬於新的事件、既有事件後續、回顧性資訊或其他類型;novelty 用來判斷這則資訊相對於歷史內容帶來多少新的資訊;impact 則描述事件可能具有的市場影響程度。
這樣的設計讓模型先回答「這是什麼資訊,以及它和過去的資訊有什麼關係」,再由後續程式根據這些欄位進行篩選。大量重複報導、既有事件的再次轉述與影響程度較低的內容可以被排除,而相對於歷史出現新變化、同時具有較大潛在影響的事件則可以進入後續處理流程。
Schema Validation 如何保護後續流程
結構化輸出的價值在於後端可以直接讀取欄位,但前提是模型輸出的格式、欄位型別與 enum 值必須符合規格。因此我們在 LLM 輸出後加入 schema validation,成功時才讓結果進入後續流程;失敗時則可以拒絕使用、重新要求模型輸出,或記錄錯誤供除錯。
| 驗證情境 | 結果 | 原因 |
|---|---|---|
| 格式完整且欄位值合法 | 成功 | JSON 格式正確、欄位型別正確,impact、category、novelty 都落在允許範圍內。 |
| JSON 語法錯誤 | 失敗 | 例如最後一個欄位後方多出逗號,系統無法解析。 |
| impact enum 不合法 | 失敗 | 例如輸出 bullish,但規格只接受 large 或 small。 |
| category 或 novelty enum 不合法 | 失敗 | 例如 category 輸出 macro、novelty 輸出 new,兩者都不在允許列表內。 |
| 欄位型別錯誤 | 失敗 | 例如 summary 是空值,或 reason_log 變成陣列;兩者在規格中都必須是字串。 |
目前處理結果
截至 2026 年 5 月,系統已累積分析 25,352 筆金融資訊。其中 6,513 筆被判斷具有較高的新穎性,575 筆被判斷具有較大的潛在市場影響,最終共有 206 筆通過完整的資訊篩選條件。
| Metric | Result |
|---|---|
| Total News Analyzed | 25,352 |
| New / High-novelty Events | 6,513 |
| Large-impact Events | 575 |
| Selected Events | 206 |
從目前的實際處理結果來看,最終只有約 0.81% 的輸入資訊通過完整篩選。尤其在同一項 ETF 申請、監管政策、交易所事件或資安事故被不同來源持續轉述的情況下,模型可以參考相關歷史資訊,將其中部分內容辨認為既有事件的重複報導或後續資訊,而不是每次都視為一個全新的事件。
目前能確認什麼,還不能確認什麼
這些數據目前只能說明系統的篩選行為與資訊縮減程度,還不能直接視為模型判斷的準確率。我們目前尚未建立足夠規模的人工標註資料,因此無法可靠計算 novelty precision、recall 或市場影響判斷的正確率。
這類評估本身也不容易建立 ground truth。「是否具有新資訊」需要放回當時的歷史脈絡判斷,而「是否具有重大市場影響」又受到整體市場、其他同時發生的資訊、流動性與短期交易行為等因素影響,無法單純用新聞發布後的價格變化判定模型是否正確。
因此,目前我們比較能確認的是:加入歷史 context 後,LLM 已經能對持續流入的新聞進行一定程度的事件區分與重複資訊過濾,將大量原始資訊縮小成較少的候選事件。至於模型對事件新穎性與市場影響的判斷究竟有多準確,仍需要後續建立更完整的 evaluation dataset 才能進一步驗證。