為什麼需要 Historical Retrieval
前一階段建立的金融資訊 data pipeline,讓不同來源的新聞可以持續進入系統,經過整理後保存成歷史新聞資料。隨著資料不斷累積,下一個問題是:當新的金融事件出現時,怎麼從大量歷史新聞中找出真正相關的背景資訊?
金融新聞通常不是獨立事件。同一件事情可能持續數週甚至數月,期間陸續出現新的進展。例如,一家公司先宣布併購計畫,之後進入監管審查、收到補件要求,最後才公布批准或否決結果。當最新消息出現時,單看這一則新聞,往往只能看到事件目前的進展,而缺少前面已經發生過的事情。
人工分析時,我們可以回頭搜尋過去的新聞,把相關事件串起來。但如果希望整個金融新聞分析流程自動運作,系統就需要具備類似的能力:在分析一則新的金融新聞之前,先從歷史資料中找出與它相關的過往資訊。
這也是我們導入 RAG(Retrieval-Augmented Generation)的原因。RAG 讓模型在分析當前新聞之前,先從外部知識來源取得相關資訊,再將這些內容作為 context 一起提供給模型。在我們的系統中,這個外部知識來源就是持續累積的歷史金融新聞資料庫。
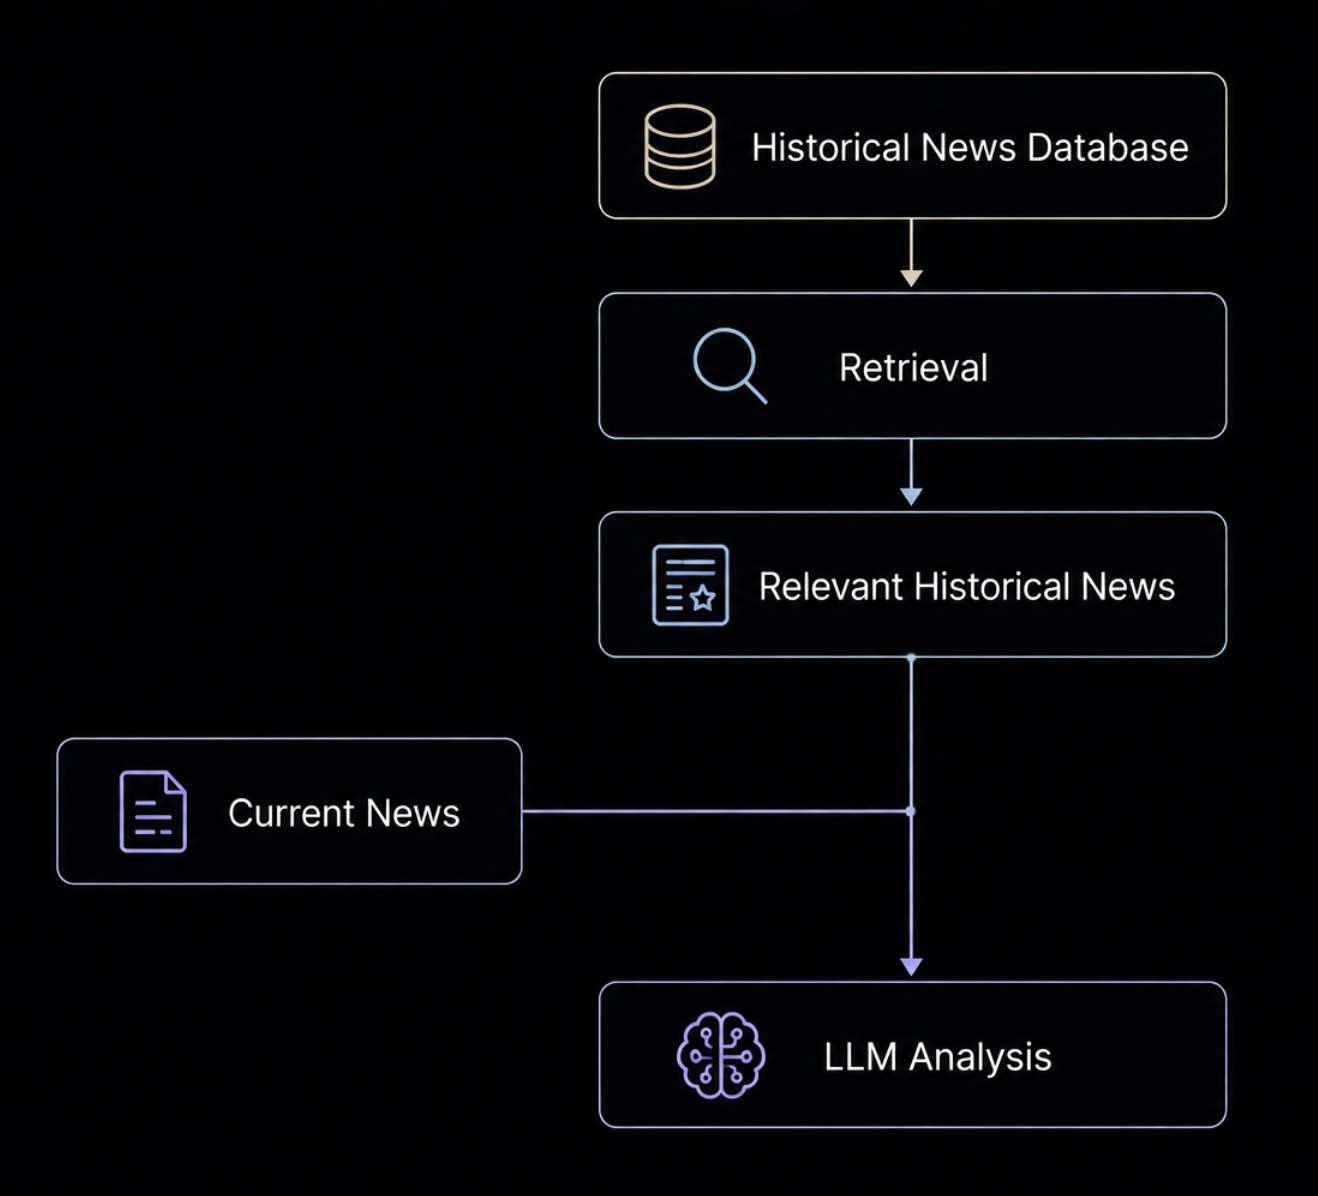
這樣的架構很適合金融新聞。歷史資料可以持續獨立累積,而每當新的新聞需要分析時,系統只需要從中取出與當前事件相關的部分,而不必把整個歷史資料庫交給模型。
不過,要讓這套方法真正發揮作用,關鍵就在於 retrieval 能不能從大量歷史資料中找出正確的背景資訊。金融新聞中的「相關」並不只是文字相似:同一個事件在不同時間、不同來源中可能有完全不同的描述方式;反過來,兩則使用相似詞彙的新聞,也不一定是在描述同一件事情。
從文字相似走向事件相關
想要尋找相關新聞最直覺的方法是搜尋相同的關鍵字。例如,如果當前新聞提到 Company A 與 Company B 的併購,我們可以直接搜尋這兩家公司名稱。但只依靠關鍵字會遇到一個問題:同一個事件在不同時間點、不同新聞來源中,可能使用完全不同的描述方式。
T-90 days   Company A announces acquisition of Company B
T-60 days   Regulators begin reviewing the transaction
T-30 days   Company A responds to regulatory concerns
T0          Acquisition receives regulatory approval
這些新聞在文字上並不完全相同,但從事件脈絡來看,它們明顯屬於同一段發展過程。因此,我們希望判斷的並不是兩篇文章是否使用相同文字,而是它們在內容與事件上是否具有關聯。
為了捕捉這種關係,我們首先利用 embedding 將新聞內容轉換成向量表示。當新的金融新聞進入系統時,也會透過相同的 embedding model 產生 query vector,再與歷史新聞進行相似度比較。這讓系統可以找出那些即使沒有使用完全相同的詞彙,但在整體語意上仍然接近的歷史新聞。
Historical News
      │
      ▼
   Embedding
      │
      ▼
Semantic Representation
Semantic Similarity 不代表一定是同一事件
Embedding 解決了純關鍵字搜尋過於嚴格的問題,但另一個問題也隨之出現。兩則新聞在語意上相似,不一定代表它們屬於同一個具體事件。
例如,某家公司可能在不同時間發生多次監管調查,或者多家公司都可能發生類似的收購、訴訟或產品發布事件。這些新聞在 embedding space 中可能相當接近,但對目前正在分析的事件而言,不一定都是有用的歷史背景。
因此,我們沒有直接把 embedding similarity 當作最終的相關性判斷,而是再加入 BM25 提供文字層級的相關性訊號。Embedding 比較適合捕捉「這兩篇新聞整體上是不是在談相近的事情?」BM25 則補充「兩篇新聞是否共享具有辨識力的名稱、事件詞彙或其他文字線索?」
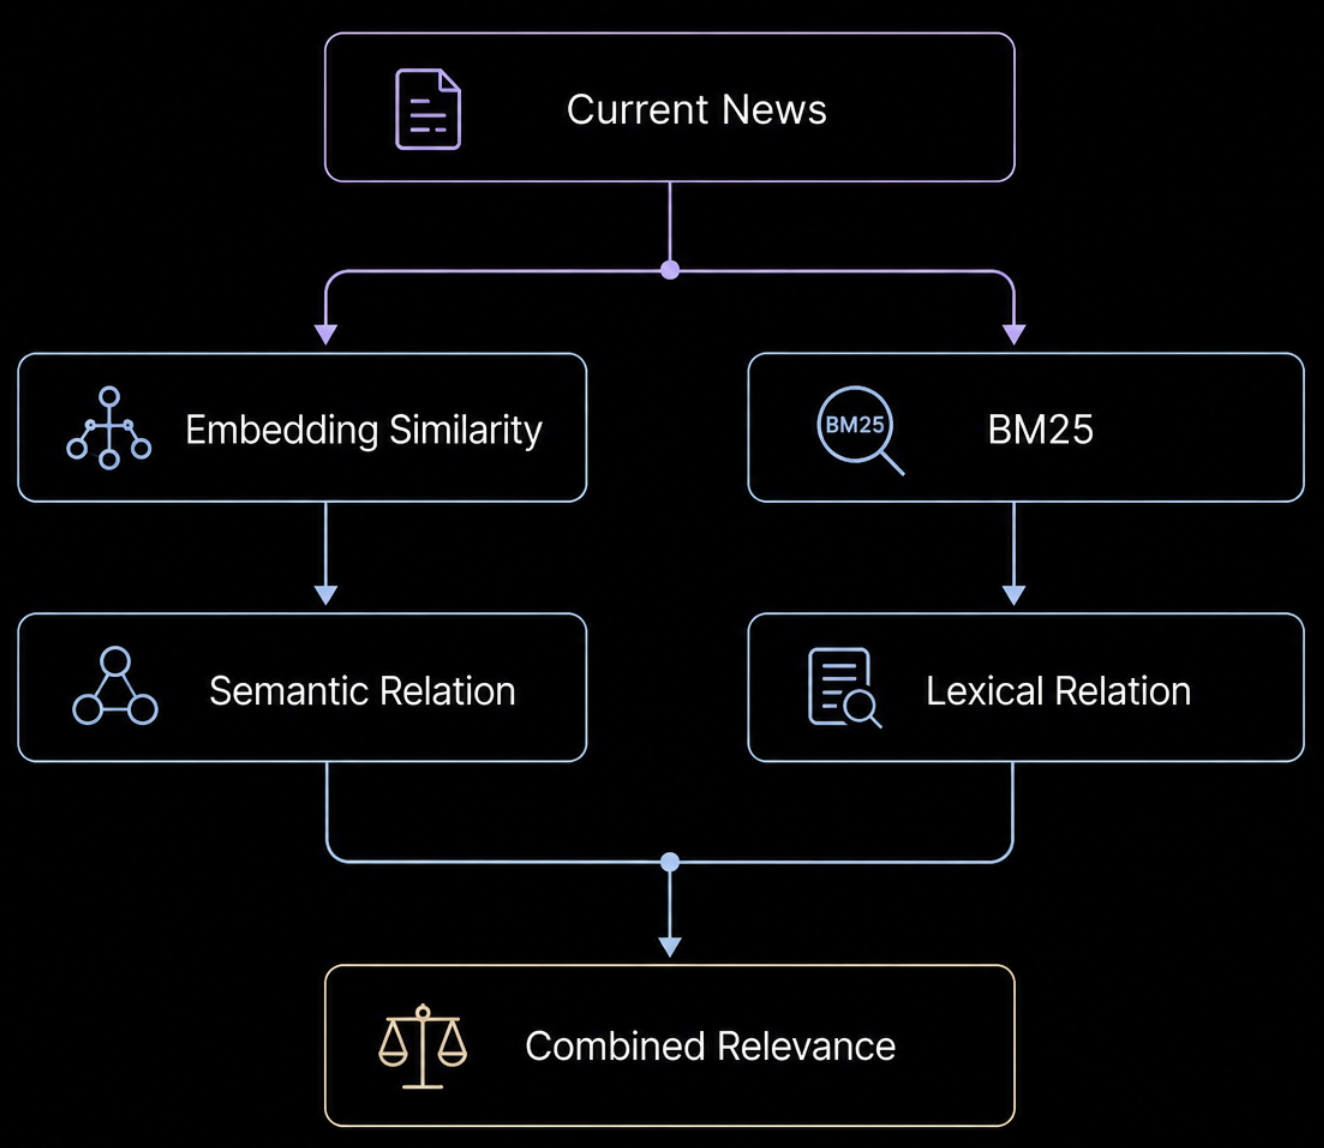
例如,兩篇新聞可能都在談監管審查,因此 embedding similarity 很高;但如果其中只有一篇提到相同公司、相同交易對手與相同監管事件,BM25 所提供的文字訊號就能幫助這篇新聞取得更高的相關性。
結合 BM25 與 Embedding 判斷相關性
在實際的 retrieval pipeline 中,我們不是直接對所有歷史新聞計算 embedding similarity,而是先利用 BM25 從歷史資料中找出文字上較相關的一批候選新聞。BM25 會根據當前新聞與歷史新聞之間的詞彙匹配程度進行排序,因此公司名稱、事件名稱、機構名稱或其他具有辨識力的詞彙,都可以成為初步檢索的重要線索。
取得候選新聞後,系統再利用 embedding cosine similarity 比較當前新聞與候選新聞的語意相似程度。這一步補充了 BM25 單純依賴文字匹配的限制,讓描述方式不同、但實際內容相近的新聞仍有機會被排到前面。
最後,我們使用 Reciprocal Rank Fusion(RRF)合併 BM25 與 embedding 產生的兩組排名,而不是直接將兩種分數相加。RRF 關注的是一篇新聞在不同方法中的排名位置,因此不需要直接比較 BM25 score 與 cosine similarity 不同的分數尺度。
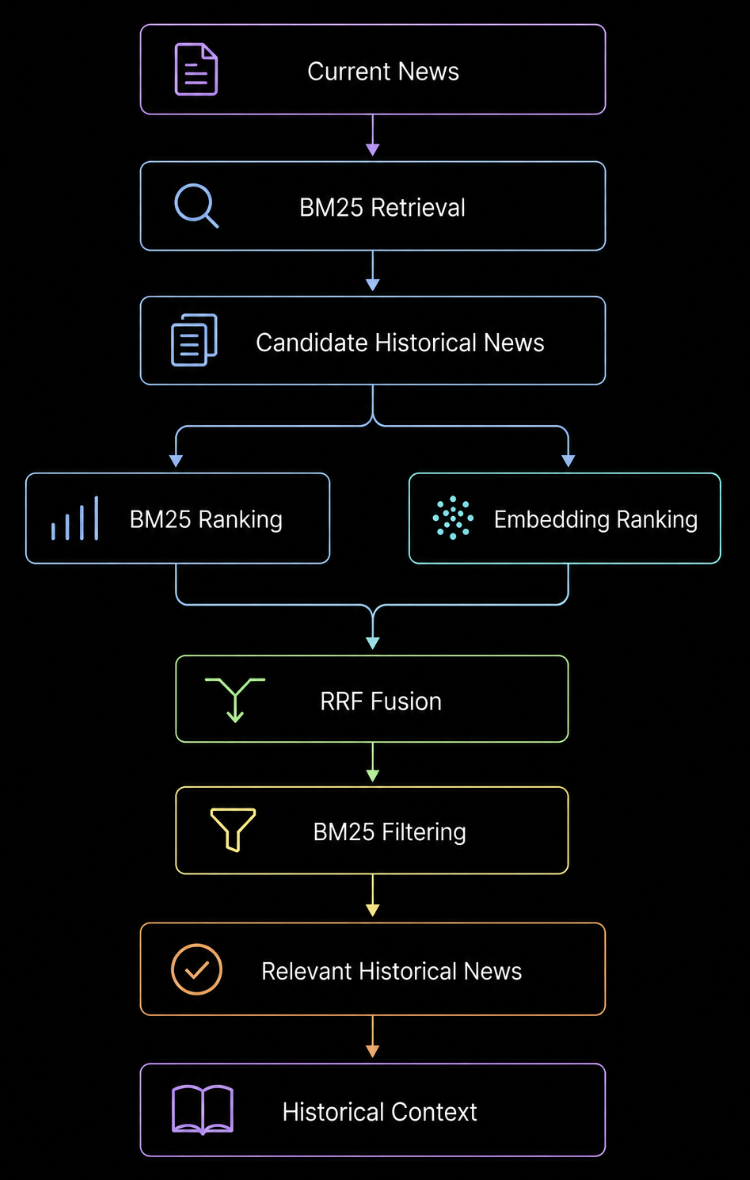
RRF 完成綜合排序後,系統還會保留一道 BM25 relevance threshold,將文字關聯過低的結果排除,避免僅因語意相似而將過於寬泛的新聞帶入 historical context。透過這個流程,BM25 負責提供具體的文字關聯,embedding 補充較寬鬆的語意關聯,而 RRF 則將兩種排名訊號整合在一起。最終留下的歷史新聞,才會作為當前事件的 historical context 提供給後續分析。
讓歷史資料重新回到當前事件中
這套 retrieval pipeline 的目的,不只是找出文字或語意上「相似」的新聞,而是希望從持續累積的歷史資料中,找出能夠補充當前事件背景的資訊。因此,我們同時利用 embedding 提供的語意關係與 BM25 提供的文字關聯,再將兩種 ranking 結合。這讓系統在搜尋歷史資料時,可以同時考慮「兩則新聞描述的事情是否接近」,以及「是否具有能夠辨認具體事件的文字線索」。
截至 2026 年 5 月,目前系統已在 25,227 筆歷史金融新聞上建立檢索索引,累積處理 21,131 次 retrieval query。每次新的金融資訊進入分析流程時,系統會從歷史資料中選出排名最高的 Top-10 新聞,作為後續模型使用的 historical context。
| Metric | Current Scale |
|---|---|
| Historical News Indexed | 25,227 |
| Retrieval Queries Processed | 21,131 |
| Context Size | Top-10 |
| Historical Coverage | 2025-11-18 – 2026-04-26 |
Top-K Historical Context 範例
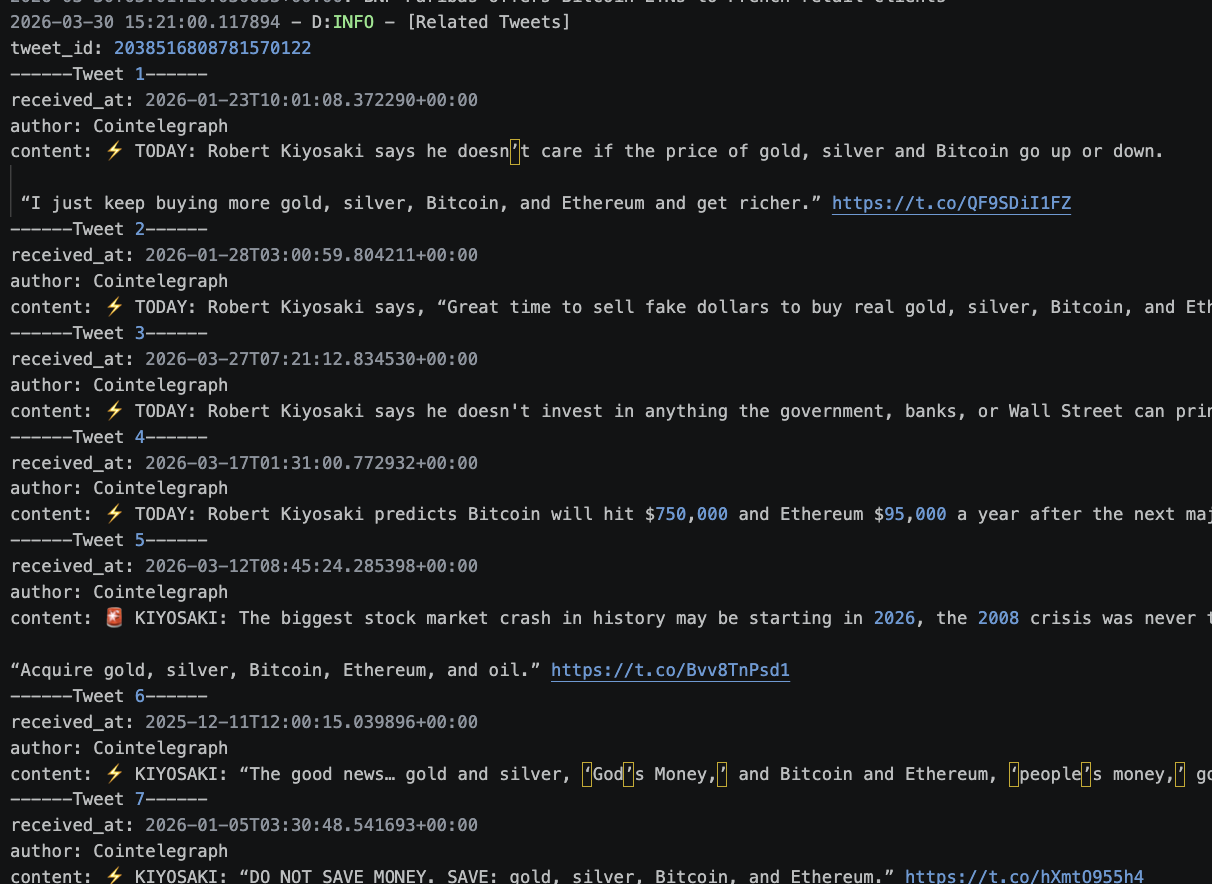
以下範例來自「建議檢附佐證」分頁,用來說明 retrieval pipeline 實際取回的 Top-K historical context。表格不是完整結果,而是保留能看出事件關聯的前幾筆範例。
| 案例 | 當前事件 | 取回的歷史脈絡 |
|---|---|---|
| Bitcoin ETF Inflow | US spot Bitcoin ETFs pulled $1.9B in 7 days | 系統取回 2025–2026 年間與 BTC/ETH ETF 資金流、BlackRock ETF 流入流出、槓桿清算等相關新聞。 |
| Trump Tariff / Supreme Court | Trump criticizes Supreme Court over tariff decision | 系統取回先前關於 Supreme Court tariff ruling、Vance/Schumer 相關評論、印度評估裁決影響與後續訴訟的脈絡。 |
| Arbitrum / KelpDAO Exploit | Arbitrum freezes exploit-linked funds | 系統取回 Arbitrum Security Council 凍結 ETH、KelpDAO exploit 與相關資金轉移的歷史新聞。 |
| Lazarus / North Korea Security | Lazarus Group security campaign | 系統取回 Lazarus Group、LayerZero、KelpDAO exploit 與加密/金融科技公司遭攻擊相關內容。 |
目前單次 historical retrieval 的內部處理時間,P50 約為 384 ms,P95 約為 863 ms,P99 約為 1.21 秒。
| Metric | Retrieval Latency |
|---|---|
| P50 | 384.134 ms |
| P95 | 863.284 ms |
| P99 | 1206.822 ms |
除了處理規模與速度之外,我們也針對 retrieval 的實際結果進行初步驗證。在目前抽樣檢查的實際金融事件中,系統皆能在 Top-10 retrieval results 內成功找回與當前事件具有實質關聯的歷史資訊,初步結果的 Top-10 event-context hit rate 為 100%。這表示目前的 retrieval pipeline 已能從超過 2.5 萬筆歷史新聞中,將與當前事件相關的歷史脈絡收斂至有限的候選範圍,提供後續 LLM 分析使用。