從即時資訊到本地儲存的歷史資料
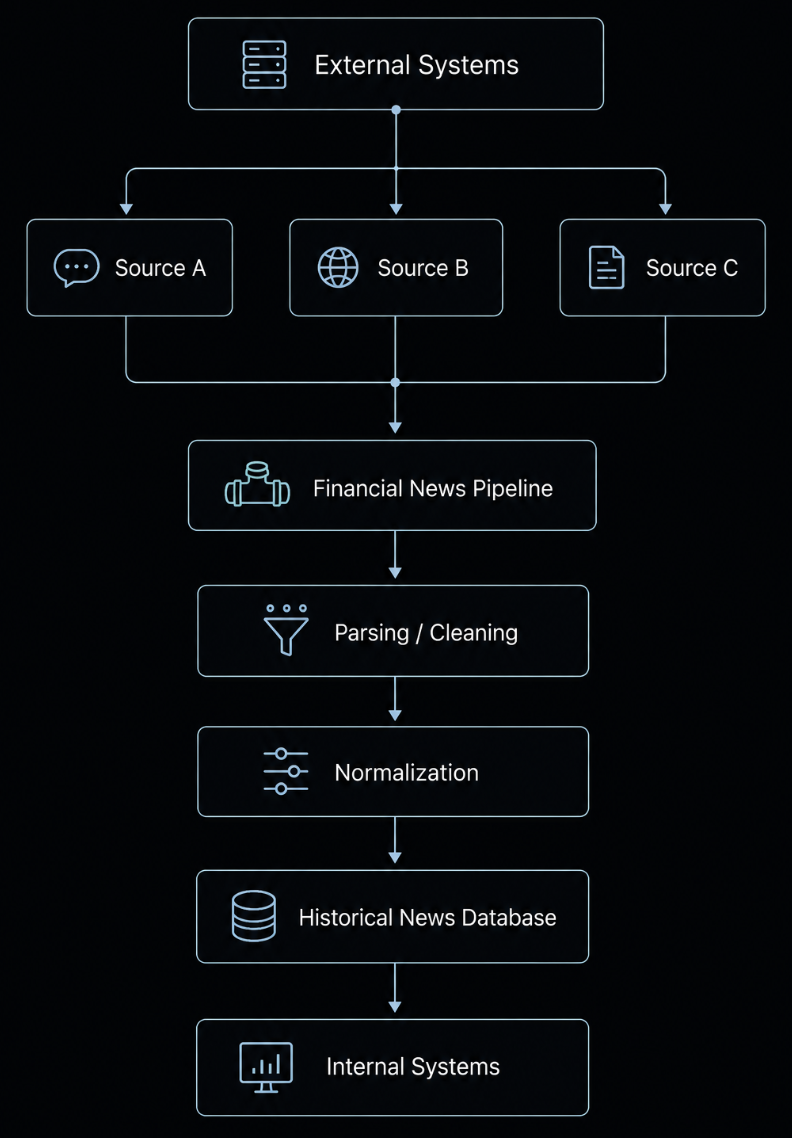
如果依靠人工逐筆蒐集與整理,很難持續追蹤大量資訊,也無法穩定累積後續研究與分析所需要的資料。為了把這項工作自動化,我們建立自己的金融資訊資料系統,讓外部資訊可以自動進入公司內部、被整理成一致的資料格式,並逐步累積成後續研究與分析可以反覆使用的歷史資料。
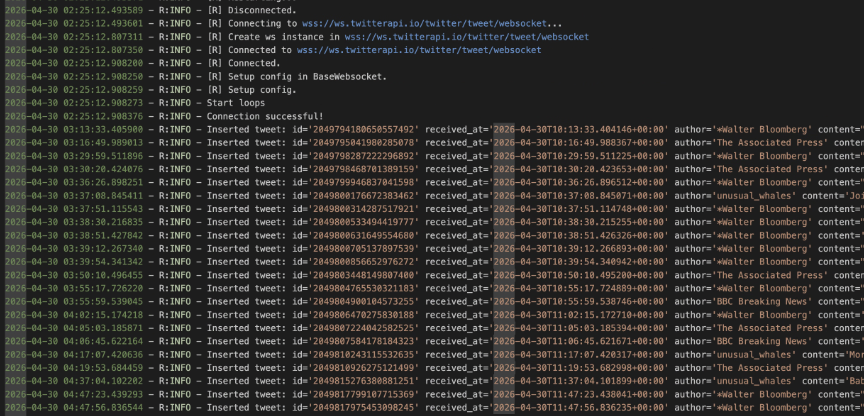
第一步是讓不同來源的金融資訊能夠自動、持續地進入系統。我們透過 WebSocket 等即時串流介面與外部資訊來源建立長期連線。當新的新聞或社群資訊發布後,資料可以直接進入系統,不需要由人員逐筆查找或定期手動取得。針對長時間運作可能發生的連線中斷,也建立重新連線與恢復機制,讓資料接收能夠持續進行。
開始接入不同來源後,接著要處理的是資料格式的差異。同樣是發布時間、作者或文章內容,在不同來源中可能使用完全不同的欄位名稱與表示方式。如果直接保存這些原始資料,後續每個使用歷史新聞的系統都必須分別理解各個來源的資料結構。
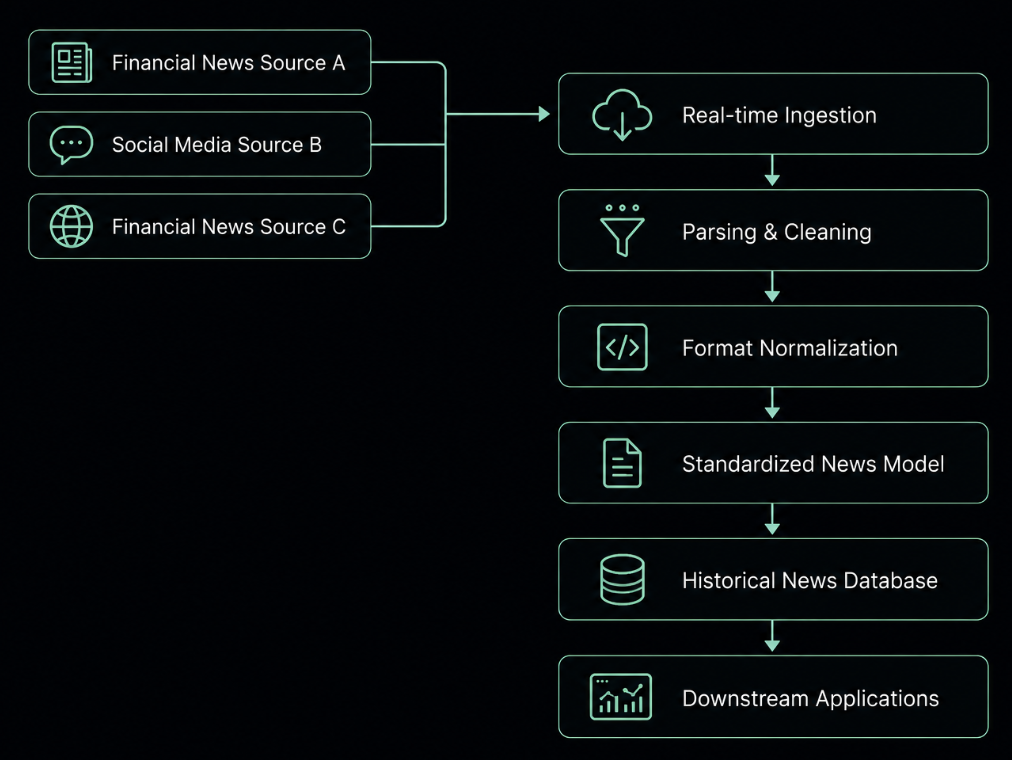
我們在資料進入系統後加入清洗與格式標準化流程。每個來源先由對應的 parser 取出需要保留的基本資訊,再將不同的欄位名稱、資料型態與時間格式轉換成統一的新聞資料模板。完成這一步後,不同來源的即時資訊已經具有一致的資料格式。
如果這些資料只在收到的當下被使用,之後想重新研究某段市場行情、查詢過去某個時間點的新聞,或利用歷史新聞進行資訊檢索,仍然需要重新向外部來源取得資料。因此,完成標準化的新聞會進一步寫入歷史新聞資料庫。每一筆進入系統的新聞除了能立即提供給後續程序,也會被持續保存,逐步累積成公司自己的歷史金融新聞資料。
持續從多個資訊來源取得資料
不同金融資訊來源有各自的資料取得方式。目前針對提供即時串流介面的來源,我們主要透過 WebSocket 建立長連線,持續接收新產生的資料。這與一次性呼叫 API 取得資料不同。Streaming ingestion service 需要長時間持續運作,因此除了正常接收資料之外,也需要處理連線狀態與實際運作時可能發生的異常。
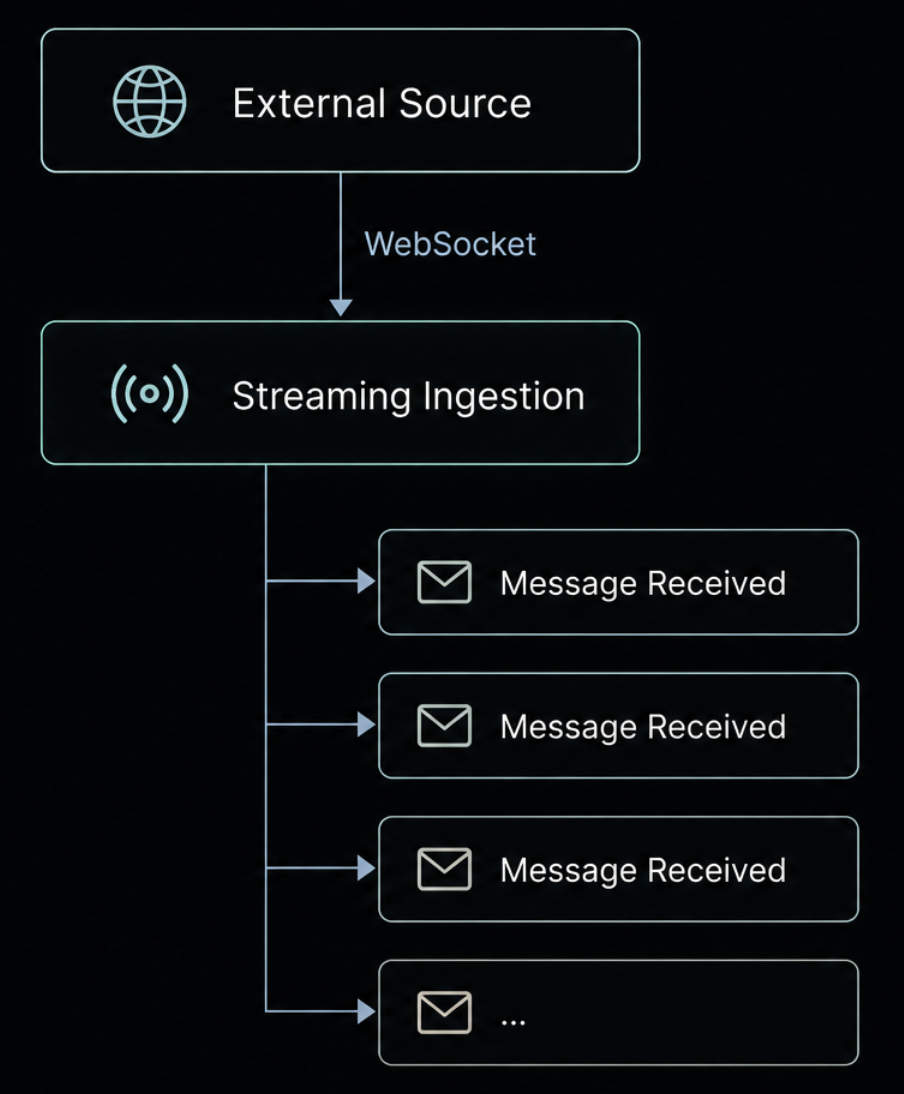
可能需要面對的情況包括 WebSocket 連線中斷、上游服務暫時無法使用、訊息格式異常、必要欄位缺失,以及單筆資料解析失敗。當收到一筆格式不符合預期的資料時,單筆資料的 parsing failure 不應該讓整個 streaming service 一起停止。當 WebSocket connection 中斷時,系統也必須自動重新建立連線並恢復後續資料接收。
這些機制的目的,是讓從資料接收到歷史保存的整條流程能夠持續運作,而不是每次遇到單筆異常或短暫斷線就需要人工介入。如此一來,這一層就能做到自動維持外部資料連線,並將持續收到的原始訊息送入後續資料處理流程。
將來源差異留在 Data Pipeline
資料進入系統之後,還不能直接寫入歷史新聞資料庫,因為每個來源送進來的 raw data 都有自己的結構。例如,兩個來源可能分別使用 created_at 與 timestamp 表示時間,或使用 username 與 author 表示作者。雖然它們描述的是相似的基本資訊,但欄位名稱、資料型態與資料所在的位置可能完全不同。
因此,每個來源都需要有對應的 source-specific parser 來理解該資訊來源的資料結構。它會從原始訊息中取出需要保留的欄位,排除不需要的資料,並處理格式異常或必要欄位缺失等情況。
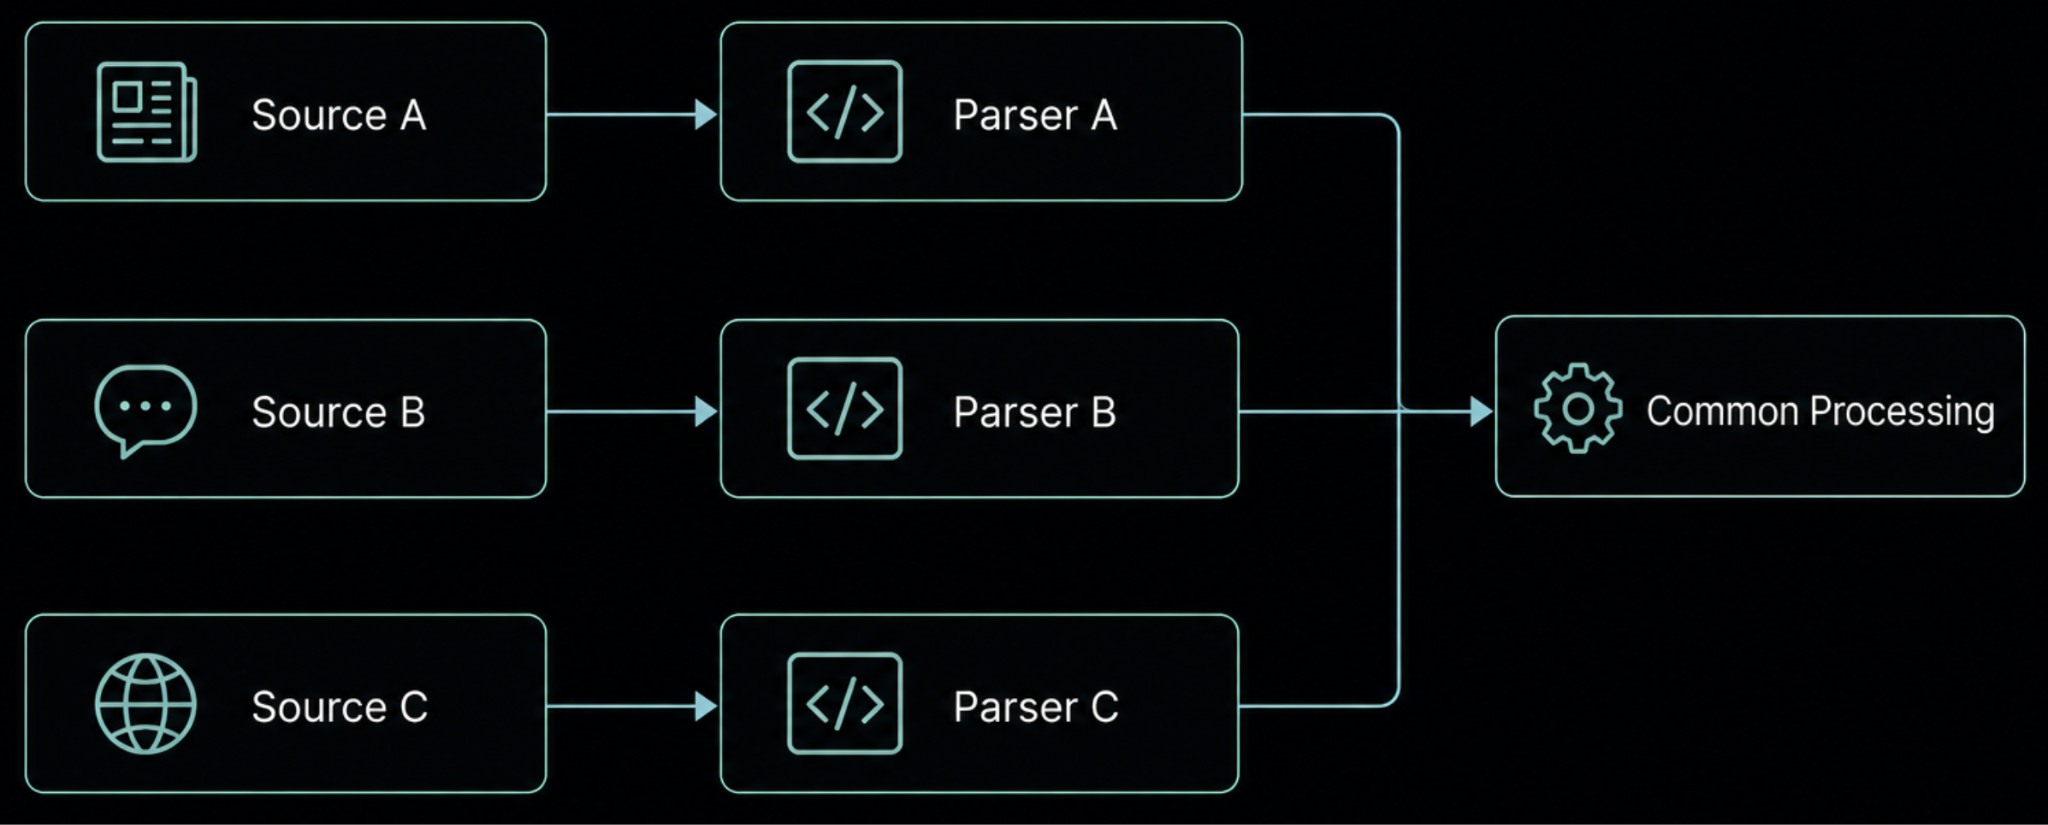
完成這個標準化流程後,外部資料來源與內部分析系統之間形成了一個明確的邊界。無論一筆資料原本來自哪個外部 API,通過這一層之後,都會變成同一種資料結構。外部資料來源的差異會被留在這一層,而後面的資料庫與分析程序只需要認識 standardized news model,而不需要知道每個來源原本的 API schema。
假如未來增加了一個新的金融資訊來源,只要新的 parser 能將資料轉換成既有的新聞模板,歷史資料庫以及使用這些資料的後續程序就不需要跟著理解新的外部格式。反過來,如果某個既有來源修改 API schema,也可以優先在該來源的 parser 中處理,而不需要讓來源格式的變動一路影響到後面的系統。
從標準化新聞建立歷史資料庫
完成處理的新聞會持續寫入歷史新聞資料庫。隨著 ingestion service 持續運作,新收到的新聞也會不斷累積,使原本一次性的即時資訊逐步形成可長期使用的歷史新聞資料。
資料保存下來之後,我們就可以依照不同需求重新取得過去的新聞。例如,透過新聞識別資訊取得特定新聞,或依照時間範圍查詢某一期間內累積的資訊,重新建立特定時間範圍內的新聞資料。除了直接查詢歷史新聞,這份持續累積的資料也成為其他分析系統的資料來源。後續程序可以直接從歷史資料庫取得需要的新聞,而不需要重新向外部資訊來源取得過往資料。
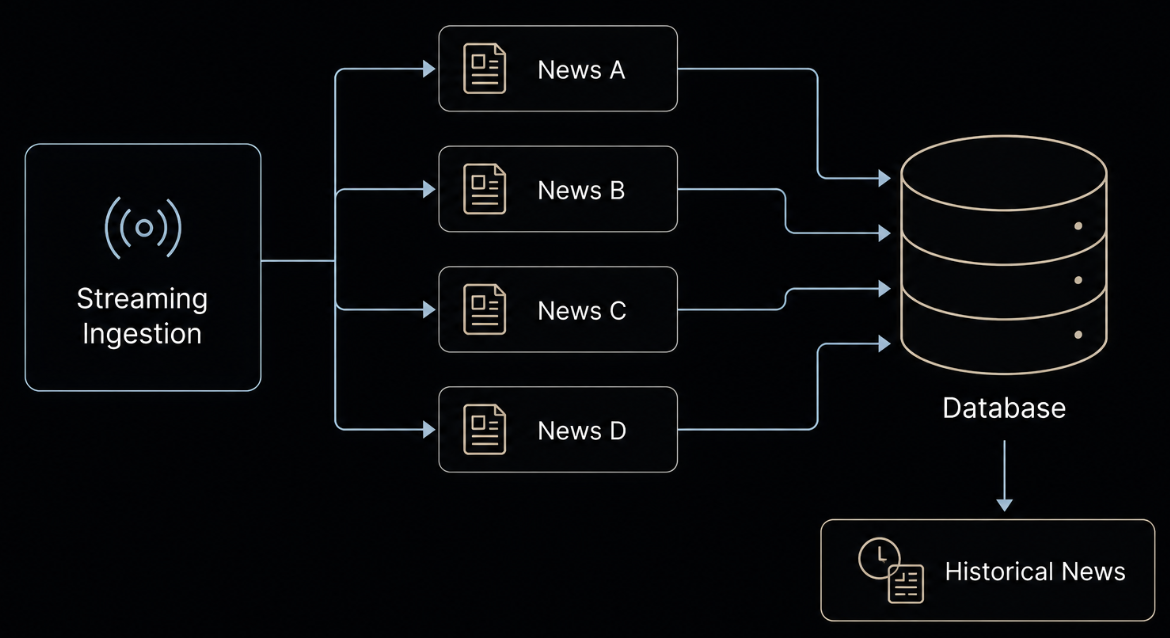
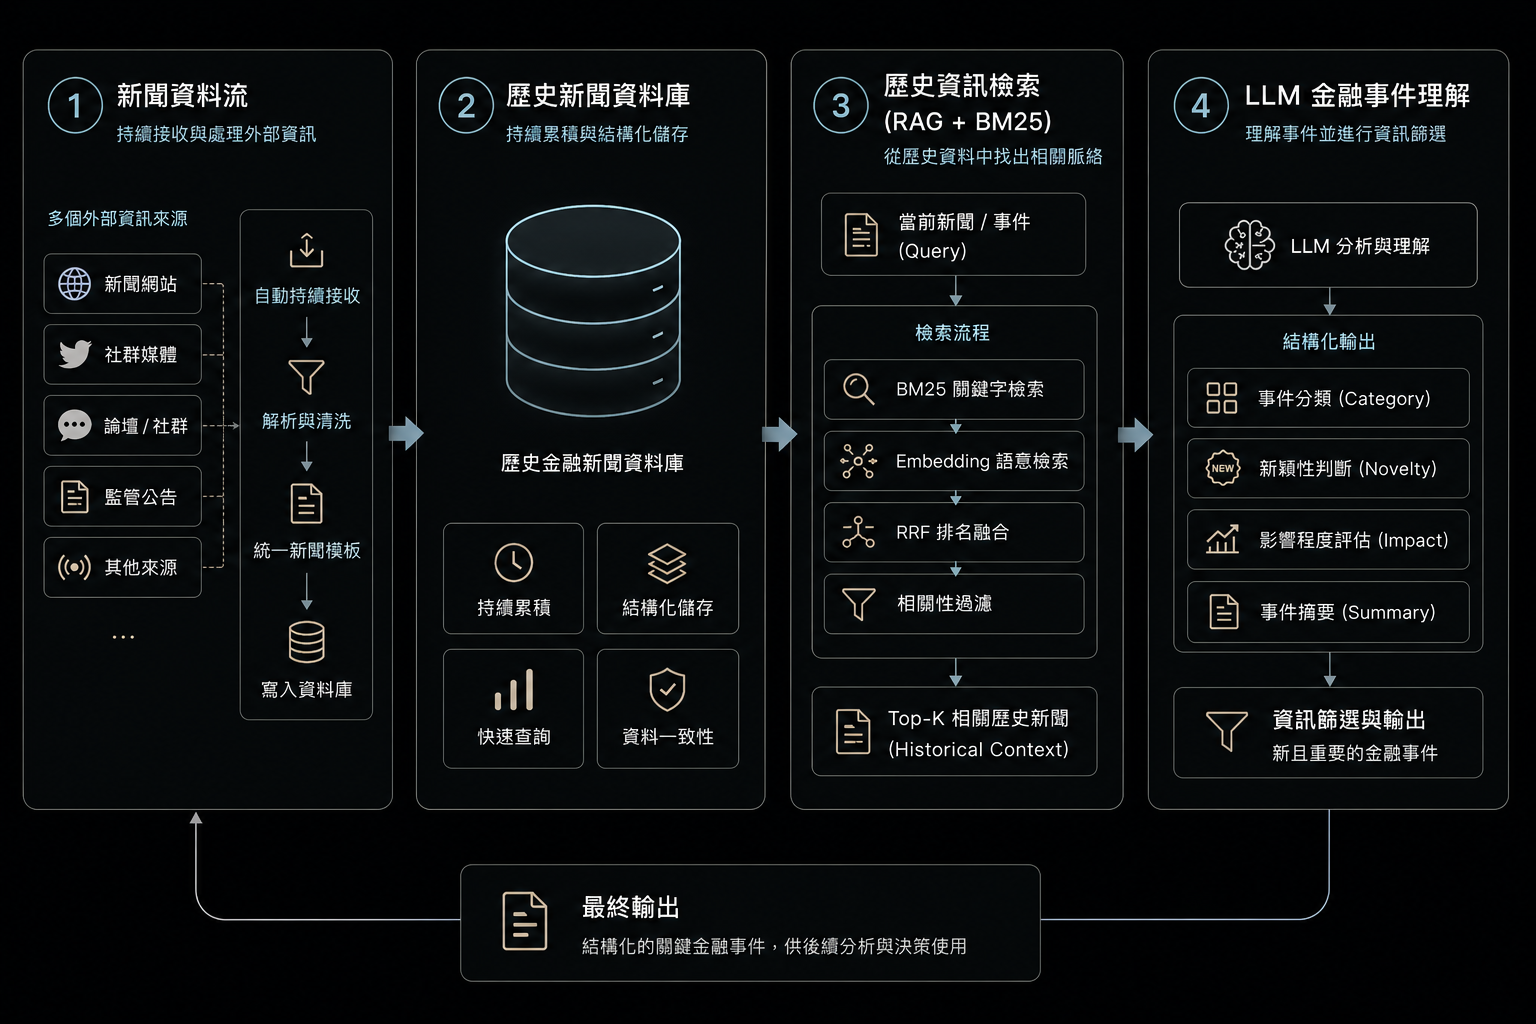
目前這份資料主要提供給三類用途:歷史金融新聞查詢與研究、歷史新聞脈絡檢索與 RAG、大型語言模型金融新聞分析。歷史新聞資料庫在整套 pipeline 中不只是資料保存的位置,也讓持續接收到的即時資訊能夠被重新查詢與反覆利用,成為後續研究、檢索與分析流程共同使用的歷史資料來源。
目前規模與處理延遲
截至 2026年5月,系統已累積保存 31,792 筆金融新聞與社群資訊,歷史資料涵蓋 2025-11-18 至 2026-04-26,平均每日新增約 203 筆資料。
| Metric | Current Scale |
|---|---|
| Total Records | 31,792 |
| Historical Period | 2025-11-18 – 2026-04-26 |
| Daily New Records | 約 203 筆 / 日 |
| 月份 | 筆數 |
|---|---|
| 2025-11 | 2,776 |
| 2025-12 | 6,393 |
| 2026-01 | 6,847 |
| 2026-02 | 6,020 |
| 2026-03 | 5,056 |
| 2026-04 | 4,700 |
除了持續累積資料之外,我們也把延遲拆成兩種不同指標觀察,避免把資料接入速度和完整分析速度混在一起看。
第一種是 ingestion processing latency:從系統收到一筆原始訊息開始,到完成來源解析、格式轉換並寫入歷史資料庫為止。這個指標只衡量單則新聞被處理好並保存下來的時間,不包含後續 RAG 檢索或 LLM 推論。
| Metric | Processing Latency |
|---|---|
| P50 | 0.621 ms |
| P95 | 1.133 ms |
| P99 | 556.152 ms |
第二種是 end-to-end decision latency:從收到 tweet 開始,到系統完成相關歷史資訊檢索、交給 LLM 判讀,並產生 decision 為止。這個時間包含 RAG retrieval 與 LLM inference,因此會明顯高於單純寫入資料庫的 ingestion latency。
| 指標 | 從收到 tweet 到產生 decision |
|---|---|
| 計算新聞筆數 | 21,131 |
| 平均延遲 | 2.780 s |
| P50 | 2.617 s |
| P90 | 3.717 s |
| P95 | 4.226 s |
| Latency Bucket | 筆數 | 比例 |
|---|---|---|
| < 2 s | 2,769 | 13.10% |
| 2–3 s | 12,178 | 57.63% |
| 3–5 s | 5,693 | 26.94% |
| > 10 s | 491 | 2.33% |
上述兩種數據衡量的都是公司內部系統收到資料後的處理時間,不包含新聞事件發生到外部資訊來源發布,也不包含外部來源將資料傳送至公司系統所產生的延遲。
佐證畫面與運行紀錄
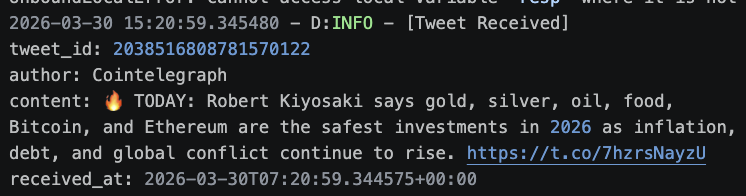
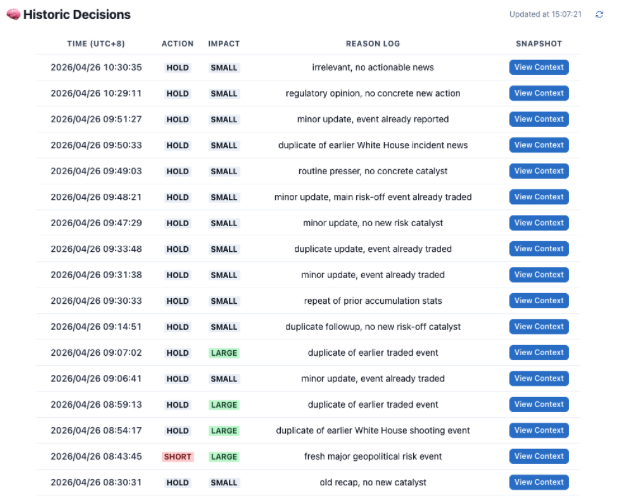
第一分頁中的佐證材料也補入這篇文章:包含整體平台架構、接入服務 log、檢索 log、schema validation log 與平台畫面。這些材料對應的是系統曾經實際接收資料、查詢歷史內容、驗證模型輸出格式並提供 dashboard 查詢的運作狀態。
共同資料層
整體來看,這套 data pipeline 做的事情很明確:將原本分散在不同來源的金融新聞與社群資訊,自動接入公司內部,整理成一致的資料格式,再持續保存成可以長期使用的歷史資料。後續的歷史查詢、RAG retrieval 與大型語言模型分析,也都可以直接建立在這份歷史資料之上,而不需要各自重新處理外部資訊來源的連線與資料格式。